地名データの漢字がひらがなになっているのはなぜ? — JIS X 0213の範囲と異体字セレクタ、2026年10月30日に戻る漢字
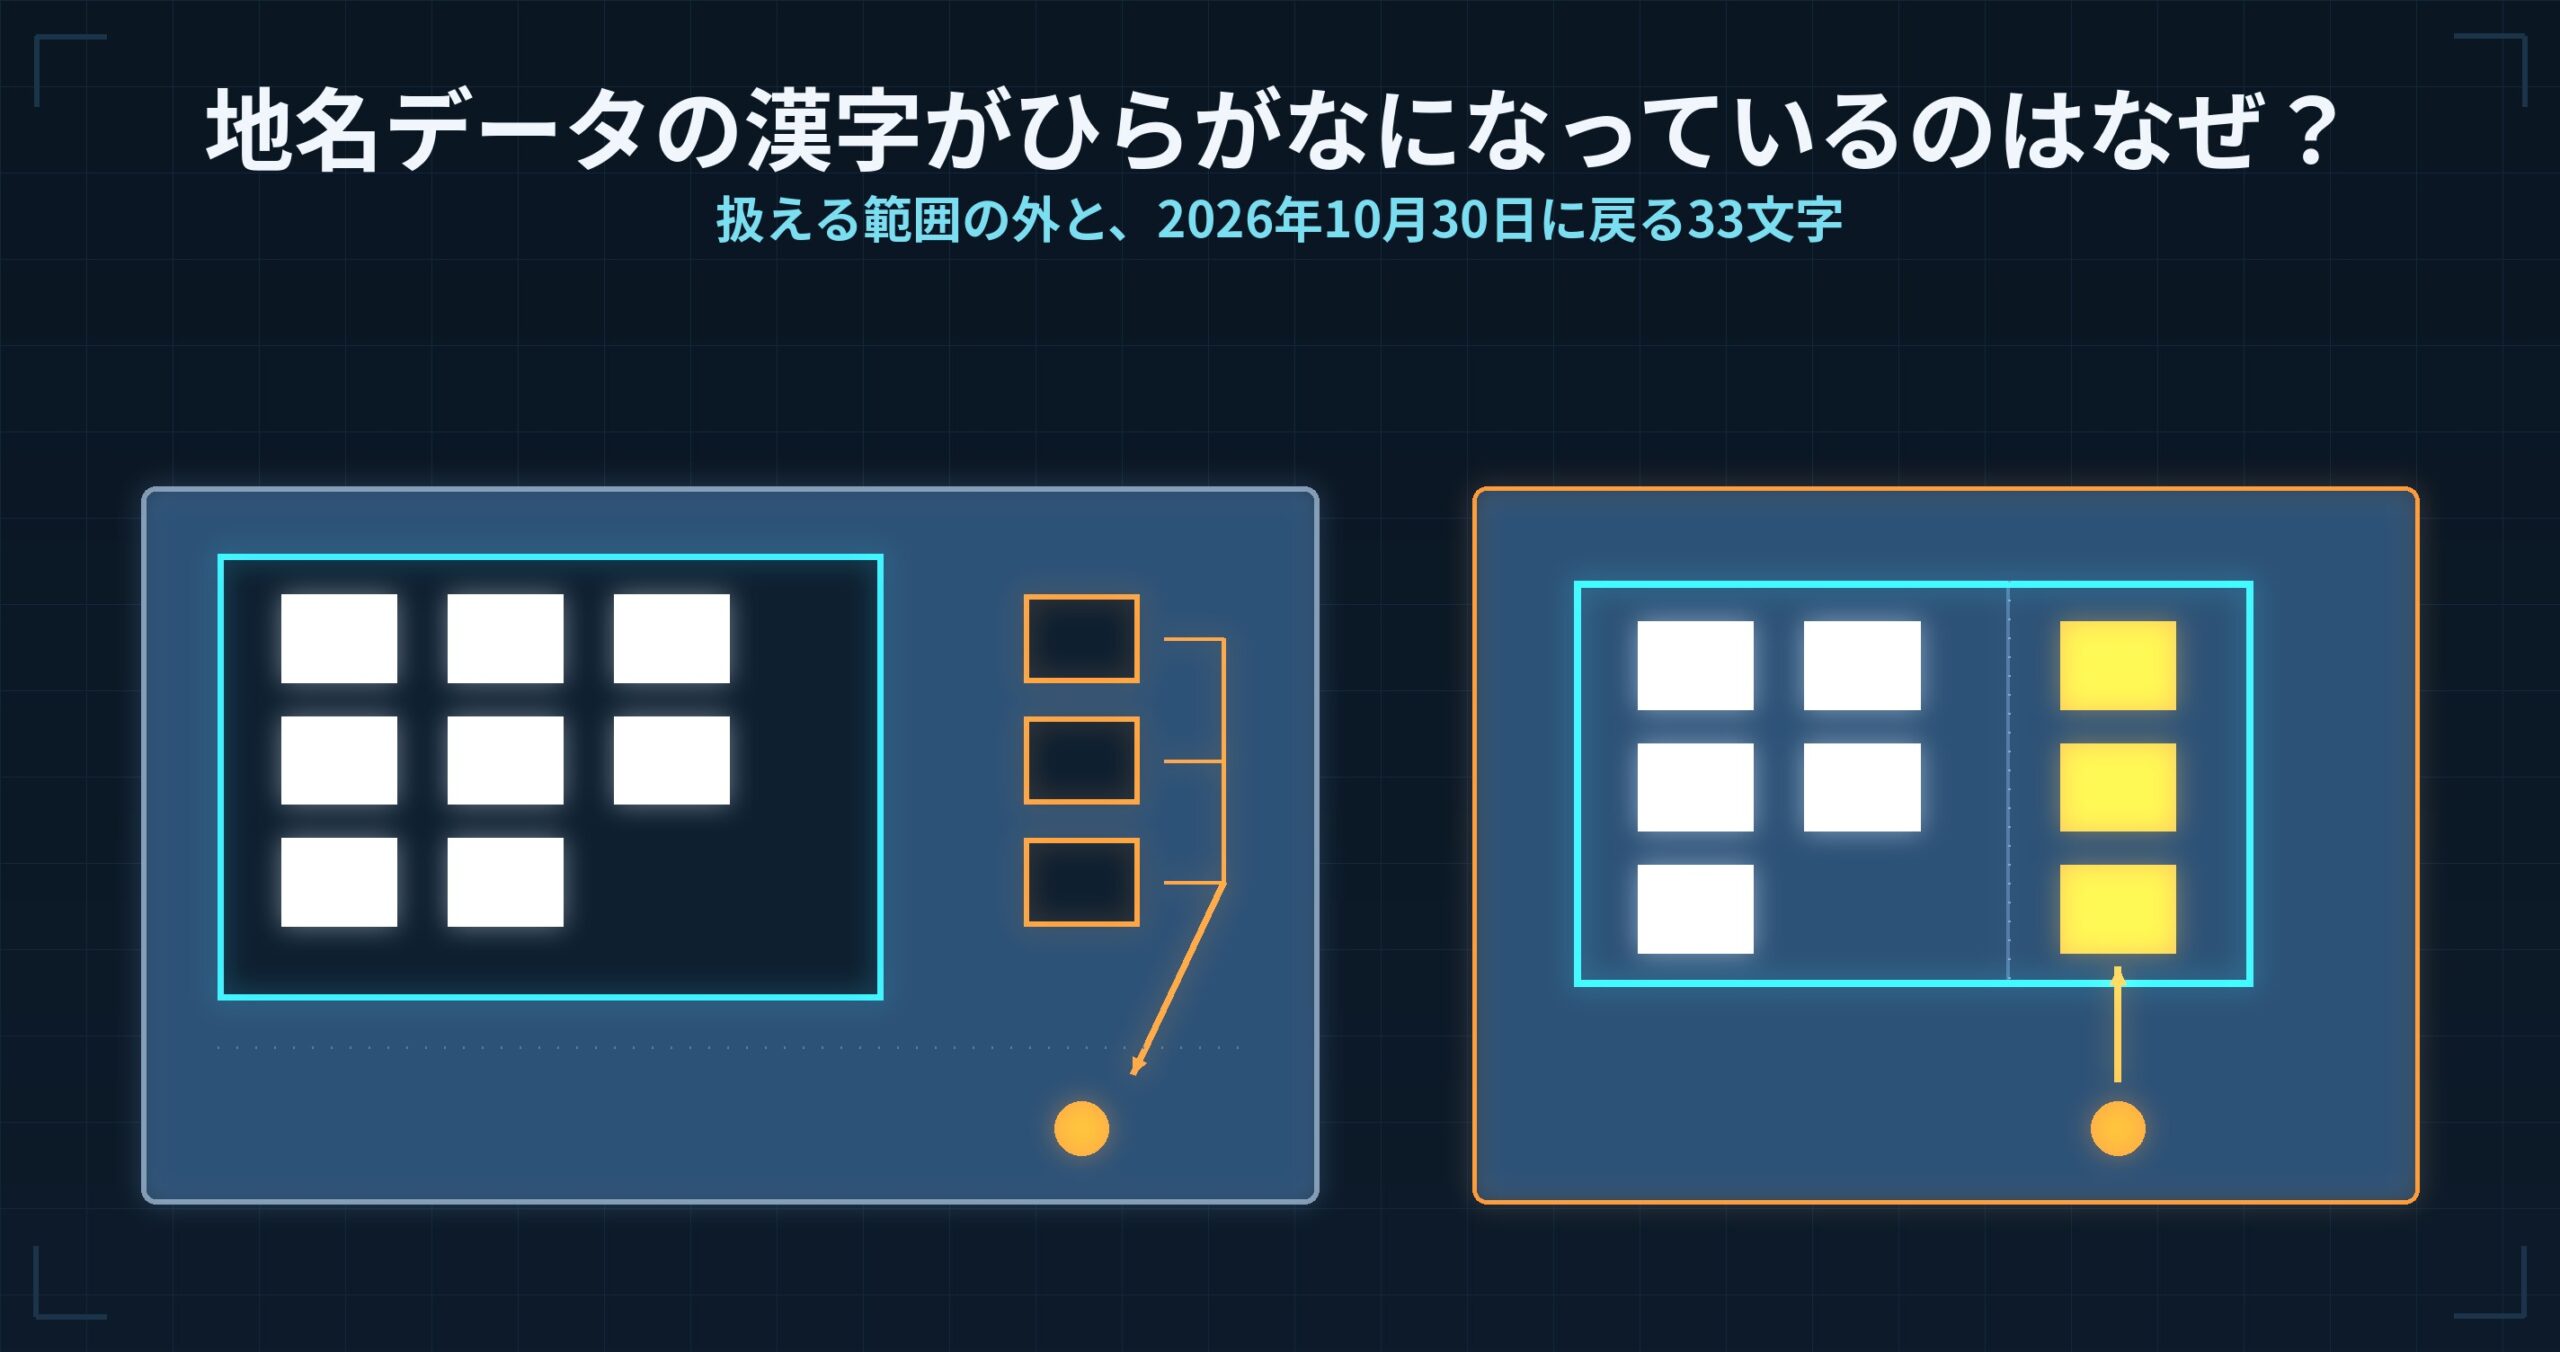
取り扱える漢字の範囲があらかじめ決まっていて、その外にある字は「同じ音・同じ意味の別の漢字」か、それも無理ならひらがなに置き換えられているからです。 文字化けでもデータの欠損でもなく、仕様どおりの代替です。そしてこの範囲は2026年10月30日以降に一部広がり、いま代替になっている字の一部が本来の文字に戻ります。
どのデータの話か
国土地理院の「地名情報」は、地図に載る地名・施設名などの文字を持ったデータです。座標値そのものではありませんが、座標と一緒に配られるため、変換や突き合わせの作業で必ず触ることになります。
- 数値地図(国土基本情報)に同梱される「地名情報」
- 電子国土基本図(地名情報)「住居表示住所」
住所や地名を座標に紐づける処理では、この文字列が照合キーになります。だからこそ「どの字で書かれているか」が効いてきます。
取り扱う漢字の3点セット
現在の仕様は、次の3つで決まっています。
| 項目 | 現在の仕様 |
|---|---|
| 日本語文字集合の範囲 | JIS X 0213(第1水準〜第4水準漢字) |
| 文字コード | JIS X 0221 |
| 文字の符号化方式 | UTF-8 |
この「3点セット」で書けない字が、代替の対象になります。
以前はもっと狭かった
変更前は、JIS X 0221 の「基本日本文字集合」に収録される第1〜第2水準漢字だけを使っていました。それに入らない字は外字または環境依存文字として扱われ、原則ひらがなに置き換えられていました。
第1〜第2水準だけだと、地名に出てくる字はかなりの割合が外れます。範囲が第4水準まで広がったのは、デジタル庁の「デジタル社会の実現に向けた重点計画」(2023年6月9日閣議決定)に基づくデータ連携の推進の一環で、一般的なパソコンやスマートフォンに標準搭載される字で書けるようにする、という考え方によるものです。反映した成果の提供は2024年3月から始まり、2024年7月19日時点で全ての2次メッシュが新しいデータ仕様になっています。
それでも代替になる3種類
範囲が広がっても、次の3つは代替の対象として残っています。
- JIS X 0213 の範囲外の漢字
- JIS X 0221 において、追加面に収録されている漢字(いわゆるサロゲートペアで表現される字)
- 異体字セレクタで表現される漢字
この3つに当たる字は、原則として JIS X 0213 の範囲内で同音・同義に考慮した代替の漢字か、当該 Unicode の基底の漢字に置き換えられ、それでも置き換えられない字はひらがなに代替されます。
「異体字セレクタ」は、同じ基底の漢字に不可視の文字を1つ足して字形を指定するしくみです。この方式で書かれた字は、基底の漢字だけが残る形に落ちます。つまり字体の差の情報が消えるわけで、見た目の違いを根拠に突き合わせていると合わなくなります。
「追加面」は、Unicode の基本多言語面(BMP)の外にある領域です。UTF-16 では2つの符号単位(サロゲートペア)で1文字を表すため、文字数の数え方が処理系によってずれる原因になります。地名の文字数で列幅やバイト数を見積もっているコードは、ここで破綻しがちです。
2026年10月30日以降、一部が本来の文字に戻る
国土地理院は、日本語文字集合の範囲を一部変更すると予告しています(2026年7月2日公表)。2026年10月30日以降、次の漢字は代替文字ではなく本来の文字で表現されます。
- 別表に掲げる漢字(JIS X 0213 の範囲外で、文字情報基盤に含まれる一部の漢字)
- JIS X 0221 の追加面で表現される漢字
参考資料として、別表・変更内容詳細(新旧対照表)・仕様の一部変更に伴い追加する漢字(33文字)の3点が公開されています。更新は「準備が整ったところから順次」とされているため、ある時期のデータでは旧仕様、別の時期のデータでは新仕様という混在状態が一定期間続くことになります。
文字情報基盤とは
独立行政法人情報処理推進機構(IPA)の文字情報基盤整備事業で整備された、行政で用いられる人名漢字等約6万文字の漢字の集合です。現在は一般社団法人文字情報技術促進協議会が保守整備し、公開性が維持されています。「戸籍や住民票に出てくる字をデジタルで扱うための土台」と考えると位置づけが分かりやすいでしょう。
実務でどう備えるか
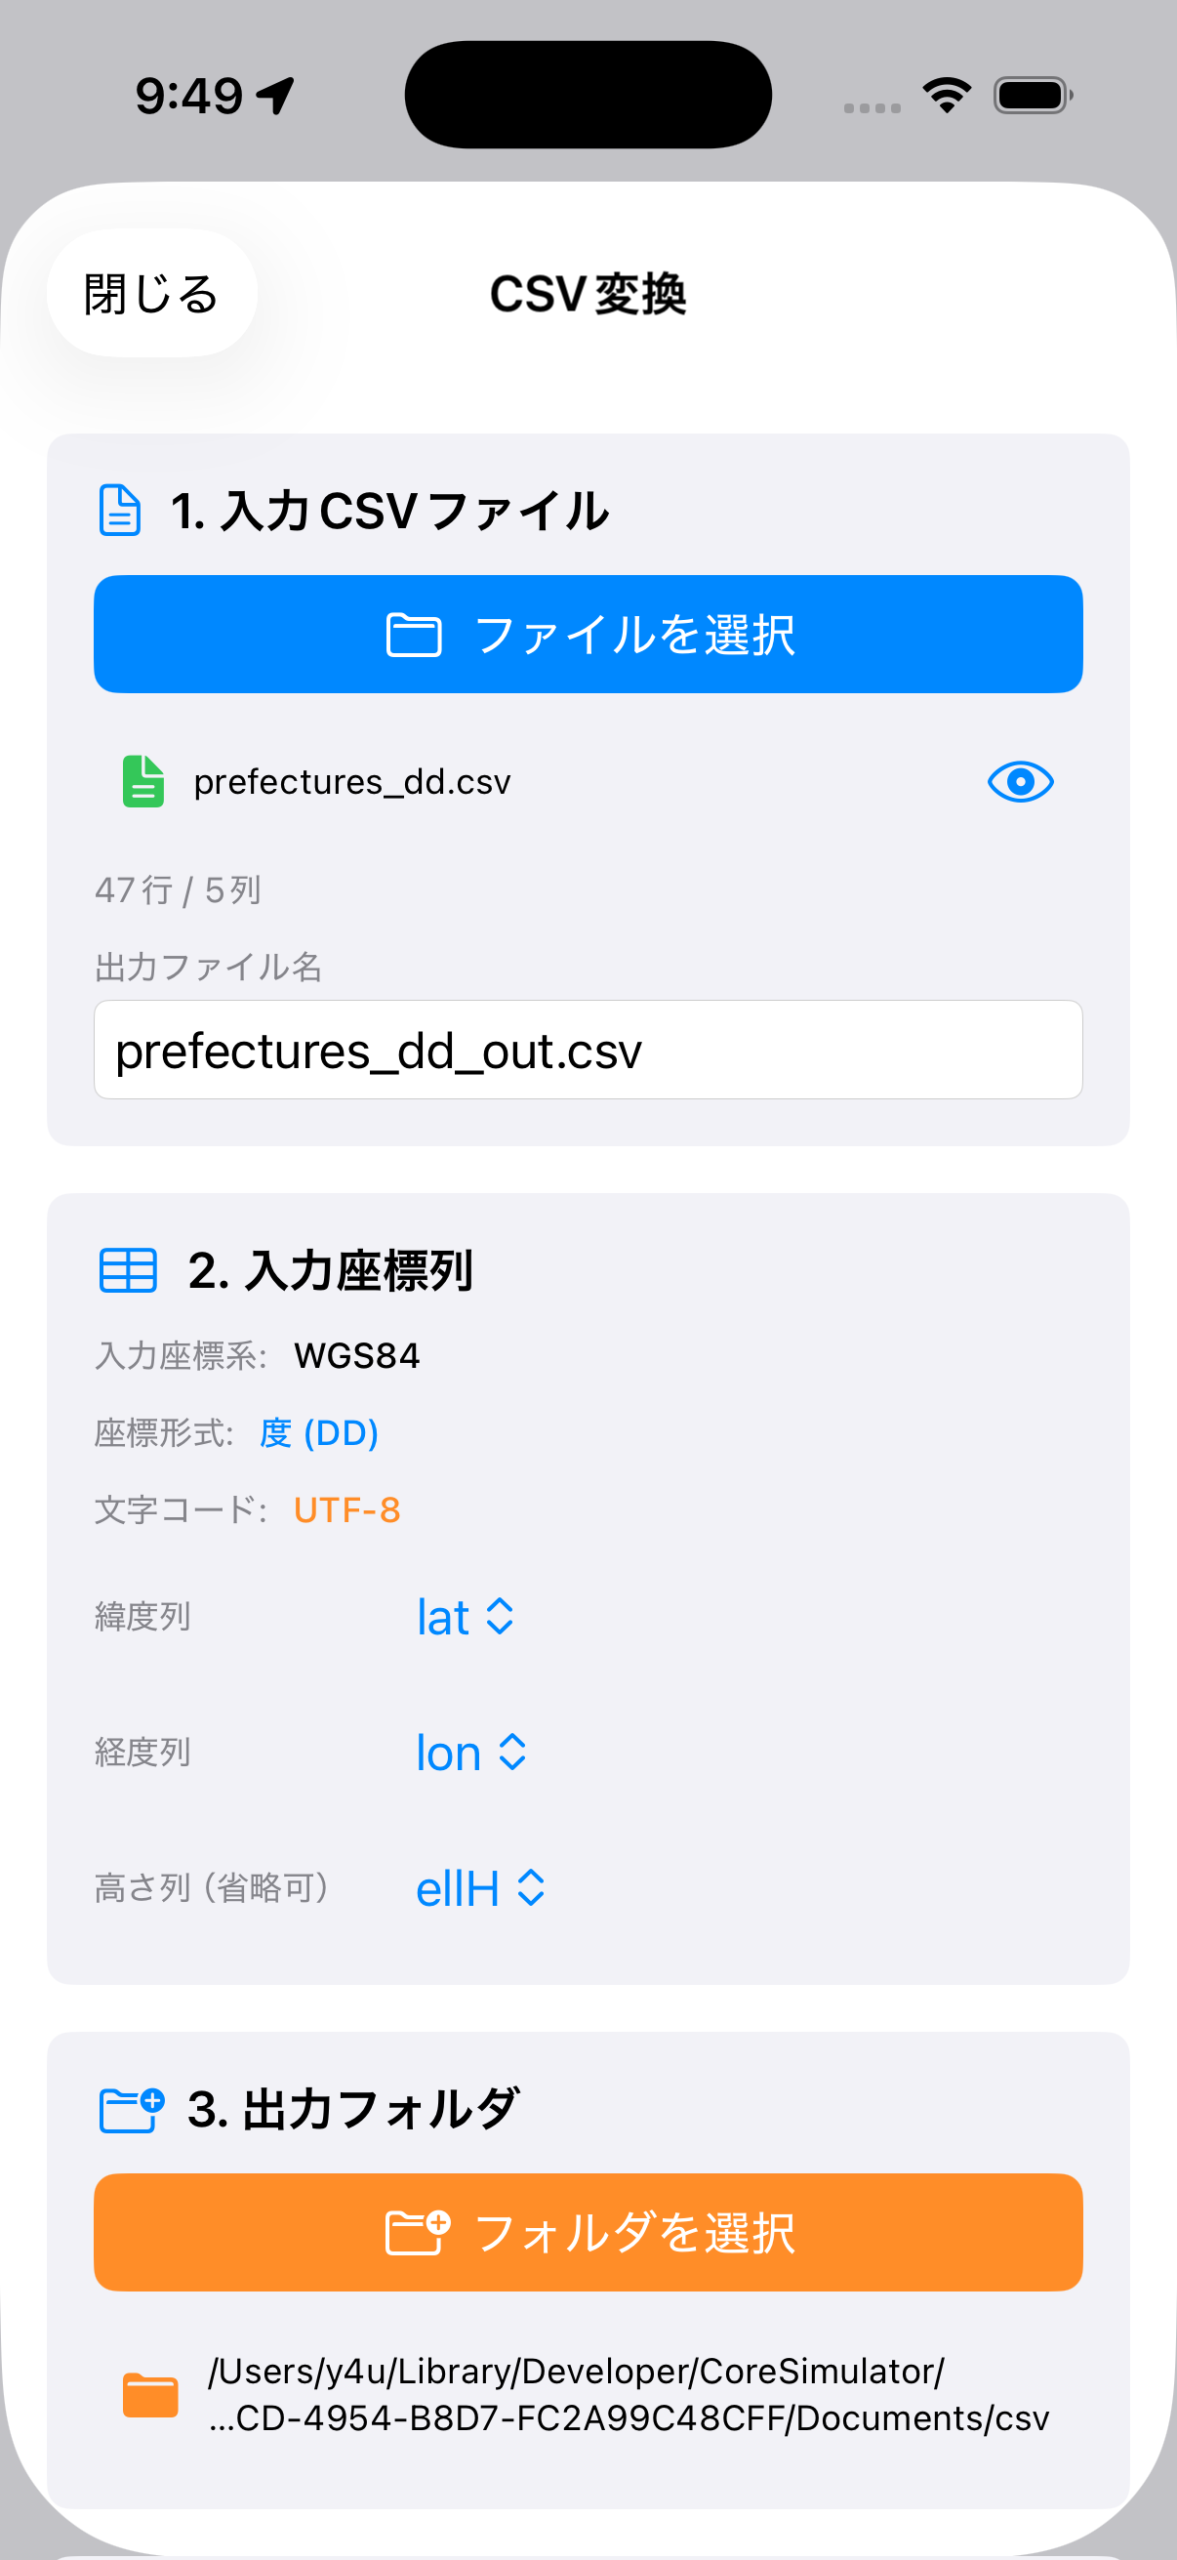
座標データのCSVを読むときに文字コードを選ぶのと同じ発想で、地名の文字列にも「どの範囲の字で書かれているか」という前提があります。やることは地味ですが、効果は大きいです。
- UTF-8で読む。 仕様で符号化方式はUTF-8と決まっています。Shift_JIS前提のツールに通すと、ここで最初に壊れます。
- 地名の文字列を一致判定の唯一のキーにしない。 市区町村コード・メッシュコード・基準点番号など、文字に依存しないキーを併用します。地名文字列だけで突き合わせると、代替された側と本来の字の側で同じ場所が別物として残ることになります。
- 追加面(サロゲートペア)を通せるか確かめる。 10月30日以降のデータには、これまで出てこなかった字が入ってきます。文字数カウント・切り詰め・正規表現の挙動を、追加面の字を含むテストデータで一度通しておくと安心です。
- 更新前後のデータを混ぜない。 混ぜざるを得ないときは、どちらの仕様で作られたファイルかをメモに残します。「順次更新」なので、取得日がそのまま世代の目印になります。
- ひらがなの地名を見つけたら、元は漢字かもしれないと疑う。 代替の結果である可能性があります。正式表記が必要な場面では、別の資料で確認します。
なお、ここまでは文字の話です。同じデータに入っている緯度経度・平面直角座標の扱いは別の問題なので、座標系の確認はいつもどおり行ってください。
まとめ
- 地名データの漢字は JIS X 0213(第1〜第4水準)/JIS X 0221/UTF-8 の3点セットで書かれている。範囲外は同音・同義の代替漢字か基底の漢字に、それも無理ならひらがなに置き換えられる
- 以前は第1〜第2水準のみで、外れた字は原則ひらがなだった。第4水準までへの拡大は2024年3月から提供が始まり、2024年7月19日に全2次メッシュが新仕様になった
- 代替が残るのは「JIS X 0213範囲外」「JIS X 0221の追加面」「異体字セレクタ」の3種類
- 2026年10月30日以降、別表の漢字(文字情報基盤に含まれる一部)と追加面の漢字が本来の文字で表現される。追加する漢字は33文字
- 更新は順次なので、新旧仕様の混在期間がある。地名文字列を唯一の照合キーにしないのが一番の備え
出典
- 国土地理院「【予告】地名情報で取り扱う漢字の仕様を一部変更します。」(2026年7月2日公表・2026年10月30日以降適用。別表/新旧対照表/追加する漢字33文字) https://www.gsi.go.jp/kihonjohochousa/kihonjohochousa41222.html
- 国土地理院「地名情報で取り扱う漢字の仕様を変更しました。」(現行仕様・例外3種・2024年7月19日追記) https://www.gsi.go.jp/kihonjohochousa/kihonjohochousa41218.html
- 国土地理院「【予告】地名情報で取り扱う漢字の仕様を変更します。」(変更の背景・変更前の仕様) https://www.gsi.go.jp/kihonjohochousa/kihonjohochousa41215.html
- 一般社団法人文字情報技術促進協議会「文字情報基盤」 https://moji.or.jp/mojikiban/project/
本記事の内容は2026年10月時点で国土地理院が公表している資料に基づきます。適用日・対象範囲は変更される可能性があるため、作業前に出典ページで最新の記載をご確認ください。
次に確認する
- 緯度経度から市区町村名を求める方法 — 座標から返ってくる地名文字列が、どの資料のどの表記に由来するのかを追えます
- 住所から緯度経度を求めるには — 住所の文字列を座標に変換する側から見た、表記の揺れの扱いが分かります
- CSVの座標を一括変換する手順 — 文字コードと列指定をどこで指定するか、実際の画面で確認できます
- 日本語フォルダ名で起きるNFD正規化の落とし穴(GeoPrism JP) — 同じ見た目の文字が別のバイト列になる現象を、ファイル名の側で体験できます
開発者より: アプリ・Kindle本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。
お願い
本記事の情報は参考目的で掲載しており、正確性・完全性を保証するものではありません。誤記・不正確な情報がございましたら、コメント欄よりご指摘いただければ、確認のうえ修正いたします。
コメントを残す