geohash(ジオハッシュ)は緯度経度でどこ? — xn76urx6 の読み方と、近傍検索で境界をまたぐ落とし穴
geohash は緯度経度を「交互のビット」に刻んで、32文字の記号に置き換えたものです。 xn76urx6 は東京駅付近の約19m×31mの区画を指します。最大の特徴は文字列の前方一致が、地図上の近さにほぼ対応すること——だからデータベースの索引と相性がよい。ただし「ほぼ」の部分に、近傍検索でつまずく落とし穴があります。
この記事は Plus Code(プラスコード)は緯度経度でどこ? で表の1列として触れた geohash を、データベースで使う側の視点から掘り下げたものです。「人が読み上げて伝える」Plus Code とは狙いが違うので、注意すべき点も違います。
geohash とは何か
2008年に Gustavo Niemeyer 氏が geohash.org とともに公開した位置参照コードです。仕様は単純で、外部データもサーバも要りません。
- 緯度経度を2分探索のビット列に変換し、5ビットずつ base32 の1文字にする
- 文字を増やすほど細かい区画になる。短いコードは長いコードの前方部分になる
- 使う文字は
0123456789bcdefghjkmnpqrstuvwxyzの32種。a・i・l・oは読み間違いを避けるため外されている
Plus Code が「人が電話で復唱できること」を狙ったのに対し、geohash は機械が文字列比較で空間を扱えることを狙っています。
読み方:経度・緯度の順にビットを交互に取る
手順はこうです。
- 経度の範囲
[-180, 180]を半分に割り、対象が上半分なら1、下半分なら0 - 緯度の範囲
[-90, 90]を半分に割り、同じく1/0 - これを経度→緯度→経度→緯度…と交互に繰り返してビット列を作る
- 5ビットたまるごとに、その値(0〜31)を base32 の1文字へ
文字と番号の対応は次のとおりです。
 0  1  2  3  4  5  6  7  8  9 10 11 12 13 14 15
 0  1  2  3  4  5  6  7  8  9  b  c  d  e  f  g
16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31
 h  j  k  m  n  p  q  r  s  t  u  v  w  x  y  z
東京駅で1文字目を作ってみる
緯度 35.681236・経度 139.767125(WGS84)で、最初の5ビットを取ります。
bit1(経度): [-180, 180]  中点 0      → 139.77 > 0      → 1  範囲を [0, 180] へ
bit2(緯度): [-90, 90]    中点 0      → 35.68 > 0       → 1  範囲を [0, 90] へ
bit3(経度): [0, 180]     中点 90     → 139.77 > 90     → 1  範囲を [90, 180] へ
bit4(緯度): [0, 90]      中点 45     → 35.68 < 45      → 0  範囲を [0, 45] へ
bit5(経度): [90, 180]    中点 135    → 139.77 > 135    → 1  範囲を [135, 180] へ

11101 = 29 → 'x'
同じ要領で続けると、東京駅は次のようになります。
| 桁数 | geohash |
|---|---|
| 4 | xn76 |
| 6 | xn76ur |
| 8 | xn76urx6 |
| 9 | xn76urx66 |
| 12 | xn76urx6606p |
戻すときは逆をやります。各文字を5ビットに開き、偶数番目のビットを経度、奇数番目を緯度として範囲を半分ずつ絞る。返ってくるのは点ではなく矩形のセルなので、代表点にするなら中心を使います。
桁数と細かさ(日本の緯度での実寸)
よく見かける精度表は赤道基準ですが、実務で必要なのは自分の現場の緯度での値です。北緯35.68度で計算し直すと次のようになります。
| 桁数 | セルの大きさ(度) | 南北 | 東西(北緯35.68度) |
|---|---|---|---|
| 3 | 1.40625 × 1.40625 | 約156km | 約127km |
| 4 | 0.17578 × 0.35156 | 約19.5km | 約31.8km |
| 5 | 0.04395 × 0.04395 | 約4.9km | 約4.0km |
| 6 | 0.00549 × 0.01099 | 約610m | 約993m |
| 7 | 0.00137 × 0.00137 | 約153m | 約124m |
| 8 | 0.00017 × 0.00034 | 約19.1m | 約31.0m |
| 9 | 0.00004 × 0.00004 | 約4.8m | 約3.9m |
| 10 | — | 約0.60m | 約0.97m |
奇数桁と偶数桁で縦横比が入れ替わるのが geohash の癖です。5ビットは奇数なので、1文字追加するたびに緯度側と経度側の分割回数の差が入れ替わります。「8桁で約19m」という言い方は、南北だけを見た数字です。
なぜデータベースの近傍検索に使われるのか
geohash が広く使われている理由は、前方一致がそのまま範囲検索になる点にあります。
-- 「xn76ur」で始まる = 約610m × 993m の中にある
SELECT * FROM points WHERE geohash LIKE 'xn76ur%';
緯度と経度の2つの範囲で検索すると、通常のB-treeインデックスは片方しか効きません。geohash なら1本の文字列インデックスの前方一致で済みます。PostGIS の ST_GeoHash()、Redis の GEOHASH コマンド、Elasticsearch の geohash grid 集計など、実装が広く揃っているのもこのためです。
落とし穴1:隣どうしなのに、文字列がまったく違う
ここが最大の注意点です。セルの境界をまたぐと、前方一致は一気に効かなくなります。
東京駅の少し北、北緯 35.68359375 度はちょうど区画の境界に当たります。この線を挟んで南北に11mだけ離れた2点を geohash にすると、こうなります。
| 地点 | 緯度 | geohash(9桁) |
|---|---|---|
| 境界の南 | 35.683544 | xn76urzrd |
| 境界の北 | 35.683644 | xn77h2p26 |
一致しているのは先頭3文字の xn7 だけです。xn7 は南北約156kmのセルですから、11m離れただけで「156kmの箱の中でしか近いと言えない」状態になります。参考までに、東京駅(xn76urx6)と境界南の点(xn76urzr)は xn76ur まで6文字一致していて、こちらは実際に約500m以内です。
近傍検索で「該当なし」や「取りこぼし」が起きるのは、たいていこれが原因です。対策は決まっています。
- 自分のセルだけでなく、周囲8セルも合わせて検索する(多くのライブラリに
neighbors()相当の関数がある) - 取り出したあとで実距離を計算して絞り込む。geohash はあくまで粗い一次フィルタ
- 「前方一致の長さ」を距離の代わりに使わない。近いなら前方一致するが、逆は必ずしも成り立たない
落とし穴2:セルは正方形でも、面積一定でもない
上の表のとおり、セルは緯度経度を等分した矩形です。したがって高緯度ほど東西が詰まります。同じ8桁でも、稚内と石垣島ではセルの横幅が1割以上違います。
統計をメッシュ単位で集計する目的なら、この不均一はそのまま結果に効きます。面積あたりの密度を出したいときは、geohash のセルを「同じ広さの区画」として扱わないでください。日本国内で面積集計をするなら、標準地域メッシュコード のほうが目的に合っています。
落とし穴3:測地系は、どこにも書かれていない
geohash の仕様には測地系の定義がありません。「緯度経度をビットに刻む」としか決めていないので、入れた座標の測地系がそのまま結果の意味を決めます。
実務上は WGS84 / JGD2011 / JGD2024 のいずれかだと考えてほぼ問題ありませんが、旧日本測地系(Tokyo Datum)の座標をそのまま geohash 化すると、約400m離れた別のセルになります。8桁セルが約19m×31mですから、20セル前後ずれる計算です。
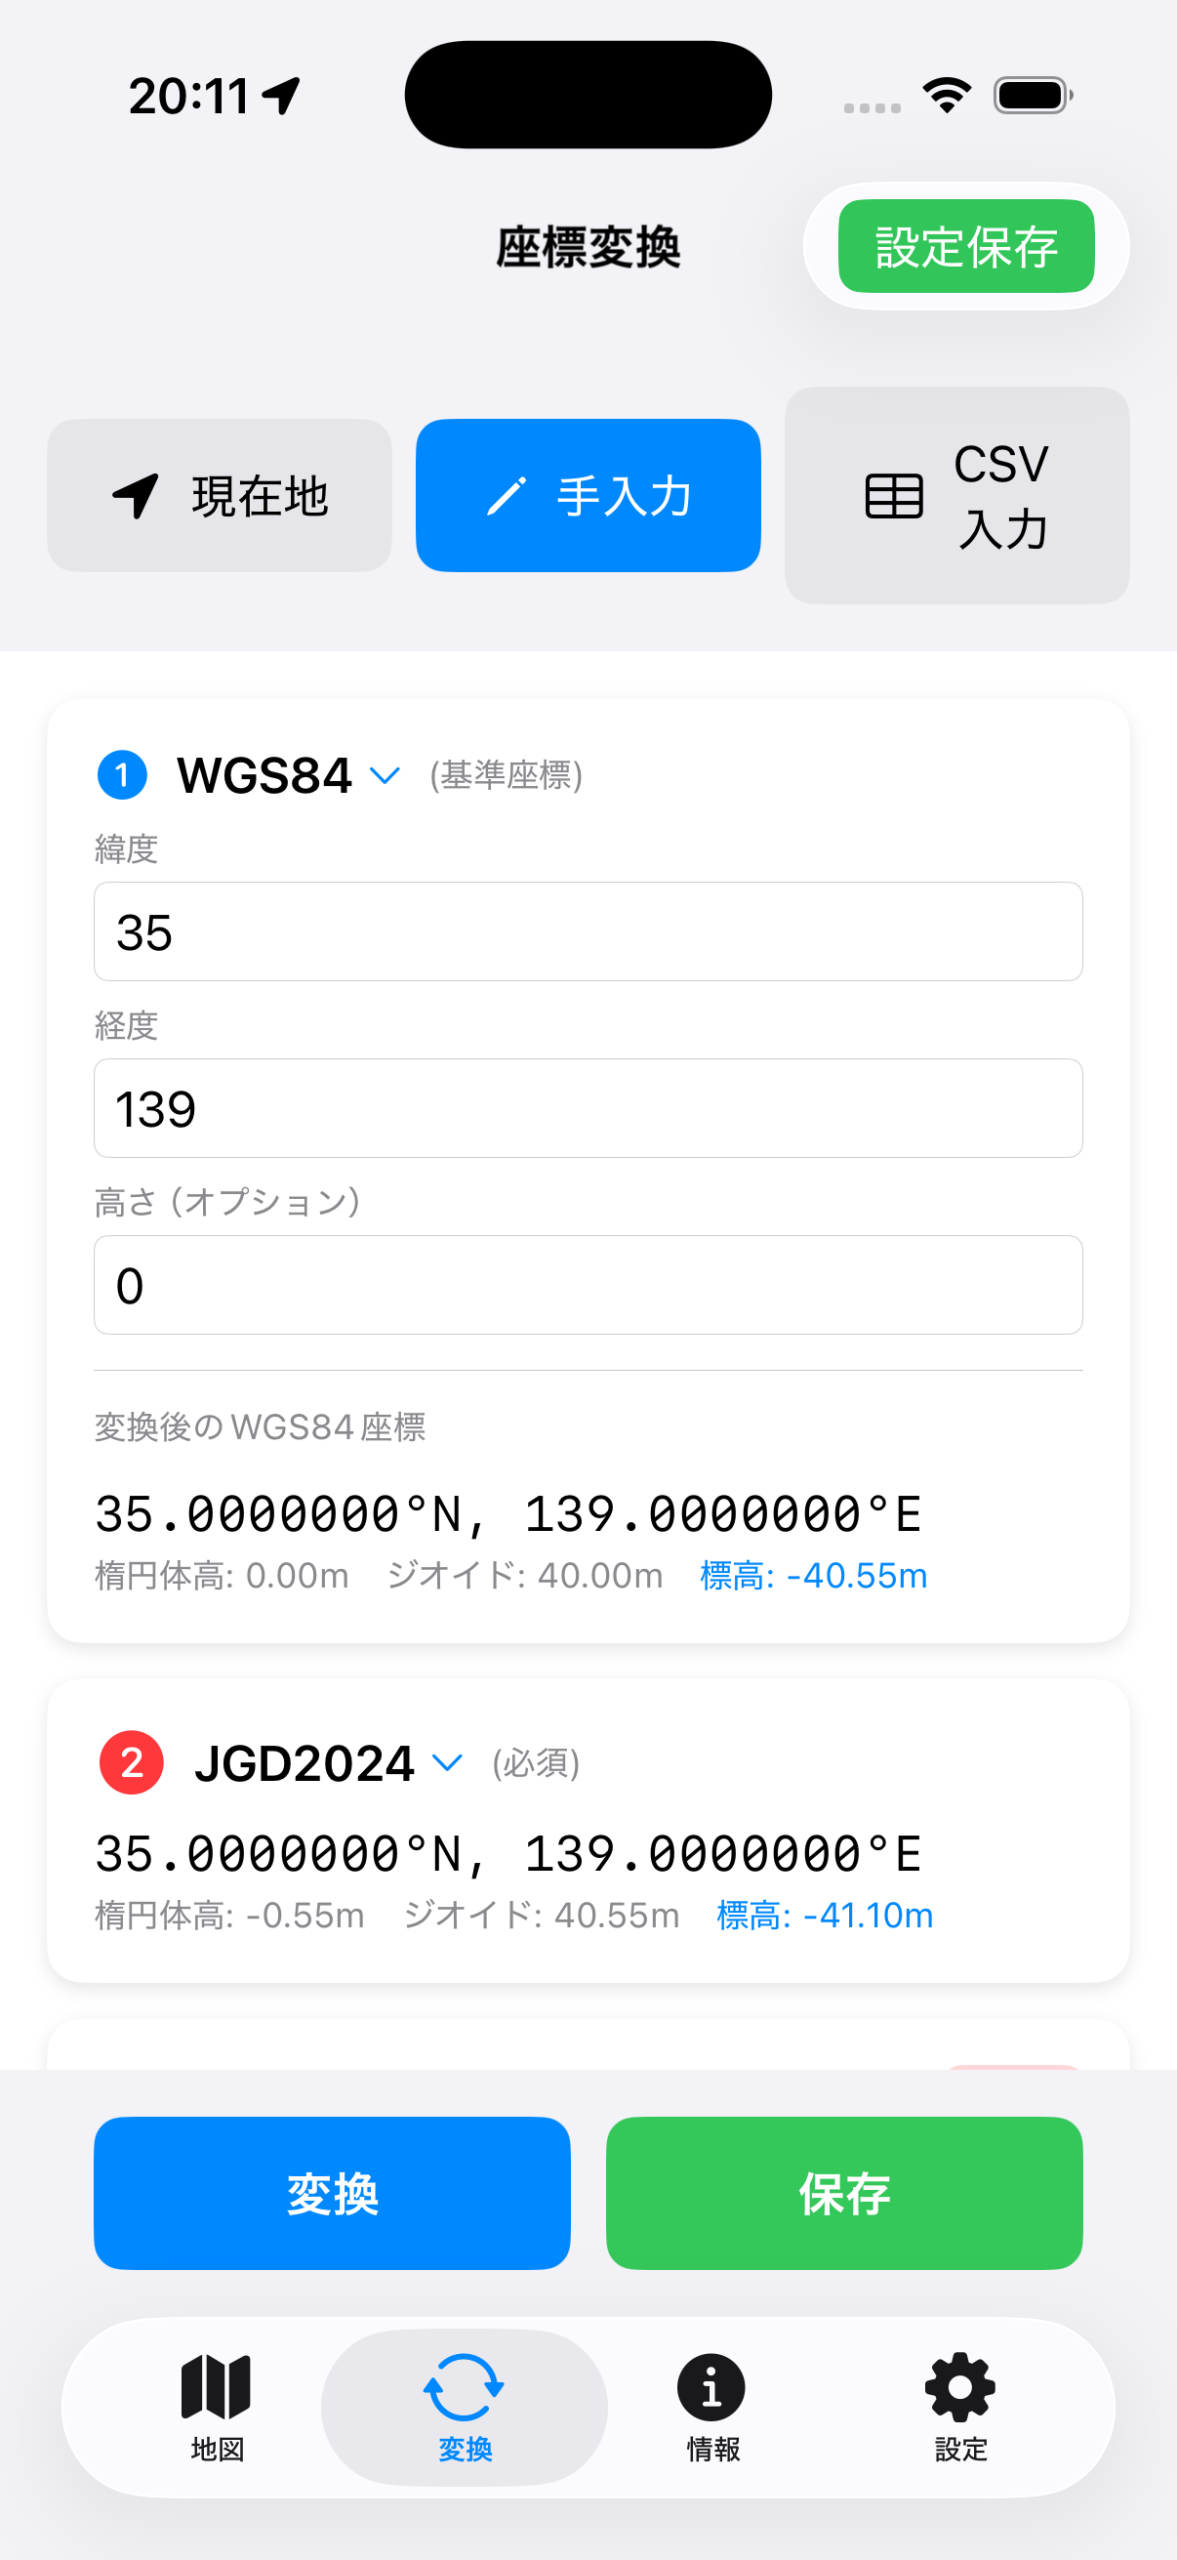
古い台帳・図面から起こした座標を扱うときは、geohash にする前に世界測地系へそろえる。順番を逆にすると、文字列だけ見ても異常に気づけません。geohash は「どの測地系で作られたか」を自分では覚えてくれないからです。
Plus Code・地域メッシュとの使い分け
| geohash | Plus Code | 標準地域メッシュコード | |
|---|---|---|---|
| 分割 | 32分割(ビット交互) | 20分割の繰り返し | 段階ごとに異なる |
| 前方一致の意味 | あり(索引向き) | あり | あり |
| 人が読み上げる | 向かない | 向く(紛らわしい文字を排除) | 数字のみ |
| 主な用途 | DBの近傍検索・一次フィルタ | 場所の共有 | 統計集計 |
| 日本での既存資産 | 少ない | 少ない | 多い(国勢調査等) |
どれも緯度経度の格子である点は共通です。選ぶ基準は「誰が読むか」——機械の索引なら geohash、人の口頭伝達なら Plus Code、統計の突合なら地域メッシュ、という切り分けになります。
まとめ
- geohash は緯度経度を経度・緯度の順に交互のビットへ刻み、5ビットずつ base32 の1文字にしたもの
- 使う文字は32種。
ailoは不採用 - 北緯35.68度では 8桁で約19m(南北)×31m(東西)。奇数桁・偶数桁で縦横比が入れ替わる
- 前方一致がそのまま範囲検索になるのが最大の利点。PostGIS・Redis・Elasticsearch に実装がある
- 境界をまたぐと文字列が一気に変わる。11m離れただけで一致が3文字まで落ちる例がある。周囲8セルを併せて検索し、実距離で絞り込むこと
- セルは正方形でも面積一定でもない。面積集計には向かない
- 測地系は仕様に書かれていない。旧日本測地系のまま入れると約400mずれた別セルになる
出典
- geohash.org: http://geohash.org/
- ST_GeoHash — PostGIS マニュアル: https://postgis.net/docs/ST_GeoHash.html
- GEOHASH — Redis コマンドリファレンス: https://redis.io/docs/latest/commands/geohash/
- Geohash grid aggregation — Elasticsearch リファレンス: https://www.elastic.co/guide/en/elasticsearch/reference/current/search-aggregations-bucket-geohashgrid-aggregation.html
- 世界測地系 — 国土地理院: https://www.gsi.go.jp/sokuchikijun/datum-main.html
本記事で計算した値(いずれも仕様どおりの符号化・復号を python3 で実装して検算)
| 値 | 根拠 |
|---|---|
35.681236 / 139.767125 → xn76urx6 |
経度・緯度交互のビット列を base32 へ |
| 8桁セル=0.00017166° × 0.00034332° | 8文字=40ビットを緯度20・経度20に分け、180 ÷ 2²⁰ / 360 ÷ 2²⁰ |
| 同・南北約19.1m / 東西約31.0m | 緯度側 × 111,132.95、経度側 × 111,319.49 × cos(35.68°) |
35.683544 → xn76urzrd / 35.683644 → xn77h2p26 |
境界 35.68359375°(= 90 ÷ 2⁹ の整数倍)を挟む2点を符号化 |
| 2点間 約11m | 0.0001° × 111,132.95 m/度 |
次に確認する
- Plus Code(プラスコード)は緯度経度でどこ? — 同じ「緯度経度を文字にする」仕組みを、人が読み上げる側から整理した回です
- 標準地域メッシュコードのしくみ — 面積集計に向いた日本の格子コード。geohash との役割分担が分かります
- 旧日本測地系(Tokyo Datum)の古い図面をどう変換する? — 約400mのズレを実際に確かめる手順です
- 緯度・経度「1度」は何メートル?(GeoPrism JP) — セルの横幅が緯度で変わる理由を図で確かめられます
- 書籍でまとめて学ぶ: 『日本の測地系Q&A』第13章「座標データの落とし穴」(Kindle Unlimited対応)
開発者より: アプリ・Kindle本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。
お願い
本記事の情報は参考目的で掲載しており、正確性・完全性を保証するものではありません。誤記・不正確な情報がございましたら、コメント欄よりご指摘いただければ、確認のうえ修正いたします。
コメントを残す